ISO/IEC 27090 術語對照與導讀
先把用語讀對,再讀標準。本頁整理第 3 章 3.1 至 3.30 全部術語:英中對照、白話意譯、條號與出處,並說明它們彼此怎麼對應。
導讀:為什麼要先讀術語
AI 資安文章常把「攻擊」講得很含糊:資料中毒、模型中毒、後門、提示詞注入,經常被混為一談。ISO/IEC 27090 的第 3 章等於替這些說法立了規矩:誰在攻擊、知道多少、打哪個資產、傷到 CIA 的哪一項,都有各自的用語。
讀這一章有三個好處:
- 統一語言:跟顧問、稽核員、廠商溝通時,「model exfiltration」與「model inversion」是不同的事,不會講到一半各說各話。
- 看懂後面的章節:第 4 章起的條文預期會沿用這些用語(條文未公開,這點未驗證)。
- 辨別話術:知道標準怎麼定義,就能分辨市面文章有沒有把概念講過頭。
標準介紹:它是什麼、不是什麼
ISO/IEC 27090:2026 的正式名稱是《Cybersecurity — Artificial intelligence (AI) — Addressing security threats and compromises to AI systems》,由 ISO/IEC JTC 1/SC 27 制定。
- 範圍(第 1 章):處理 AI 系統特有的資安威脅與入侵,說明威脅的後果,以及如何偵測與緩解。涵蓋 AI 系統整個生命週期。
- 適用對象:開發或使用 AI 系統的各類型、各規模組織,包括公司、政府機關與非營利組織。
- 定位:序言(Introduction)明講這是給組織的指引。它建議沿用 ISO/IEC 27001、27002 的既有做法,AI 特有的威脅是在這個基礎上「加層」,並不取代傳統資安。
- 引用標準(第 2 章):ISO/IEC 22989(AI 概念與術語)與 ISO/IEC 23053:2022(ML 型 AI 系統框架)。第 3 章也先指向這兩份文件的術語。
序言還點出兩個重要觀念:其一,資料中毒不一定只發生在訓練階段,持續學習的系統在運作時收進來的資料,也可能變成下一輪的訓練資料;其二,模型可以只靠「合法查詢」被竊取,即使傳統措施都到位也防不住,所以偵測成了難點。
分類地圖
第 3 章的編號沒有依主題排列。為了好讀,我把 30 條重新分成六組:
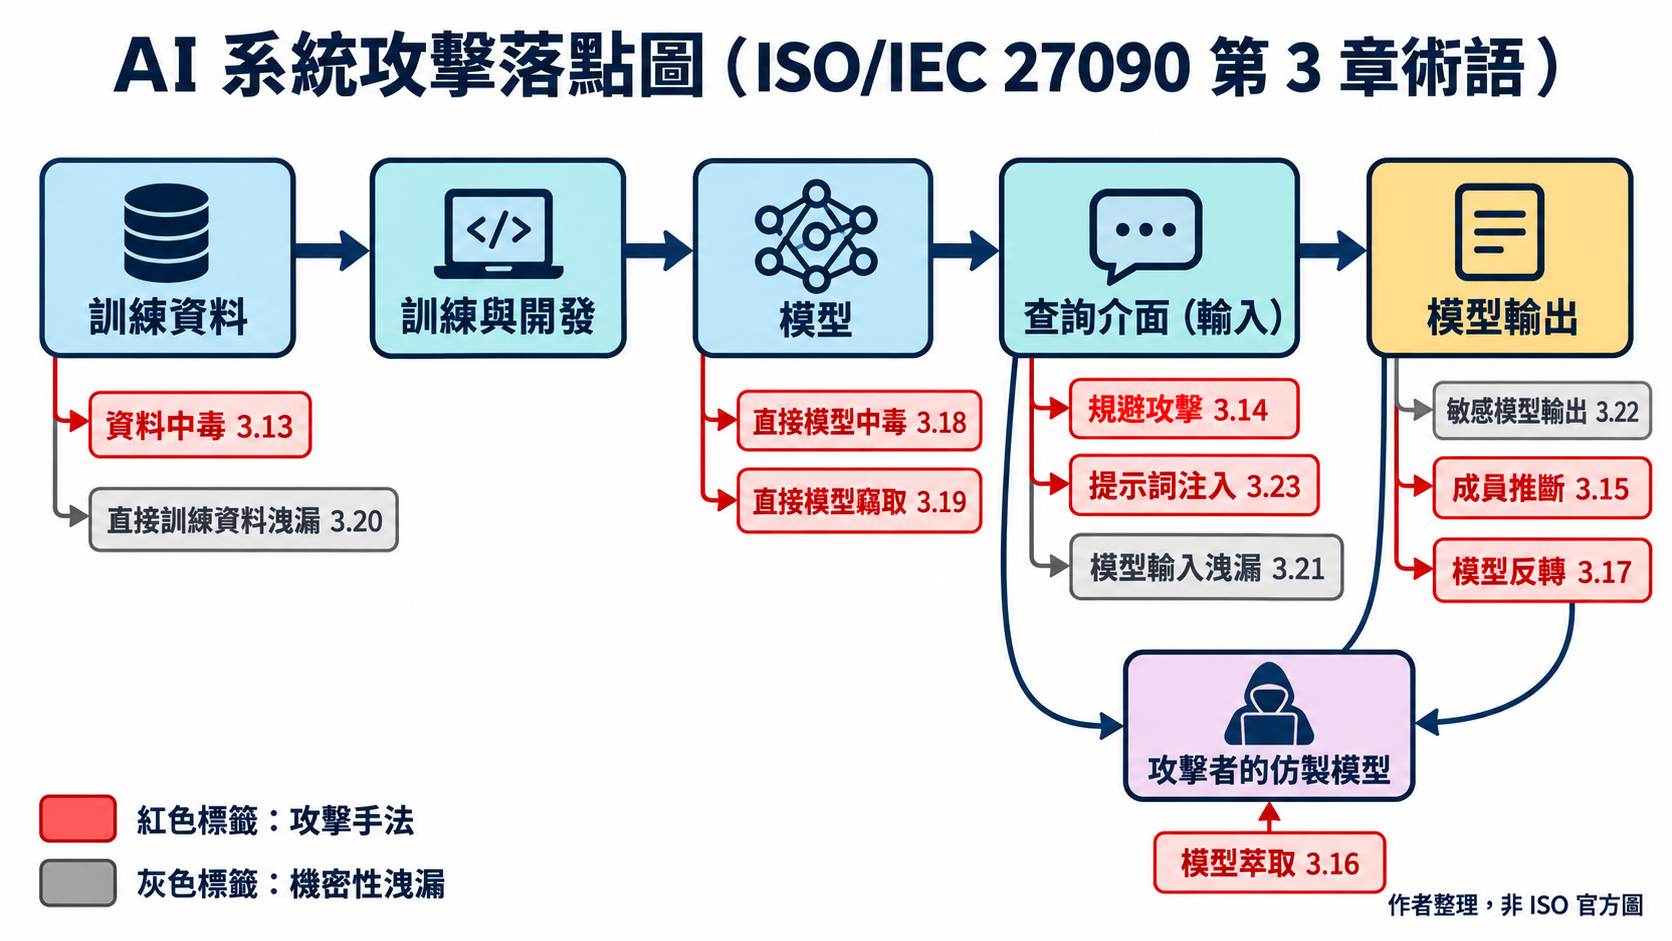
| 攻擊類型 | 對象 | 主要傷到 | 條號 |
|---|---|---|---|
| 資料中毒 | 訓練資料 | 完整性 | 3.13 |
| 直接模型中毒 | 模型本身 | 完整性 | 3.18 |
| 規避(對抗性) | 推論時的輸入 | 完整性 | 3.14 |
| 提示詞注入 | 送進系統的指令內容 | 完整性(可連帶機密性) | 3.23 |
| 成員推斷 | 某筆資料是否在訓練集 | 機密性 | 3.15 |
| 模型反轉 | 重建訓練資料 | 機密性 | 3.17 |
| 模型外洩(萃取) | 以查詢複製模型功能 | 機密性(智財) | 3.16 |
| 直接模型竊取 | 模型參數 | 機密性 | 3.19 |
← 手機可左右滑動表格。「主要傷到」欄是我依各條定義的語意所做的歸納,標準本身不是這樣列表。
術語對照(3.1 至 3.30)
① 資安基本語彙
被授權的使用者需要時,就能存取並使用,系統與資訊「用得到」。
📖 導讀
情境:AI 客服被灌爆流量、模型服務被癱瘓,使用者打不開。
留意:答錯不算可用性問題,那屬於完整性(3.3)。
資訊不會被未經授權的個人、實體或程序取得或揭露。
📖 導讀
情境:員工把客戶名單貼進外部聊天機器人;模型回答時吐出別人的資料。
資訊的正確性與完整性,沒有被不當竄改或缺漏。
📖 導讀
情境:訓練集被混入錯誤標籤,模型判斷從此偏掉。
留意:定義裡的「完整」指沒有缺漏或被不當竄改,不是單指資料量夠不夠。
② 威脅語言
可能造成意外事件、進而傷害系統或組織的潛在原因。重點在「潛在」,還沒發生。
📖 導讀
情境:「有人可能用大量查詢複製我們的模型」是威脅;真的有人動手,才是攻擊(3.5)。
留意:風險評估列的是威脅,事件紀錄記的才是攻擊。
未經授權、意圖破壞、改動、癱瘓、取得資產,或竊取、濫用資產的嘗試。成功與否都算。
📖 導讀
情境:攻擊者對 API 做了一輪探測,全被擋下來,仍然算攻擊。事件紀錄不要只記成功的。
刻意利用技術性與非技術性控制的弱點,以竊取或危害資訊系統與網路、或讓合法使用者無法使用的人。
📖 導讀
情境:可以是寫對抗樣本的研究員,也可以是在網頁埋惡意文字的人。
產品無法再執行所需功能,或無法在事先規定的限度內運作。
📖 導讀
情境:模型遇到從沒見過的資料而答錯,是失效,不一定有人攻擊。
留意:失效不等於攻擊,詳見下方閱讀心得第 2 點。
降低某個事件造成的負面後果。注意它的重點是「減輕後果」,不等於完全防止。
📖 導讀
情境:對外服務加上偵測與限制,被濫用時損害較小,但不保證不被打。
留意:序言提到,可採多層防護(defence-in-depth)來緩解 AI 威脅。
資產或控制措施中,可能被一個或多個威脅(3.4)利用的缺陷。
📖 導讀
情境:存取控制設得太鬆,這個控制措施本身就是弱點。
留意:序言指出,AI 對訓練資料的依賴,帶來額外的弱點。
③ 攻擊者知識程度
這三條描述「攻擊者事先知道多少」,是 AI 攻擊分析的標準切法:黑箱、灰箱、白箱。
假設攻擊者完全不知道目標系統內部資訊的攻擊。攻擊者可利用背景或歷史資訊推測模型弱點,也可以探測系統找出弱點。
📖 導讀
情境:陌生人只能對外開放的 API 送請求,不知道模型架構。
留意:名稱容易誤導:「零知識」不代表攻擊者什麼都不知道,也不代表打不成。
假設攻擊者完全了解系統內部資訊的攻擊。對 AI 系統而言,可能包括內部架構、變數或模型目前狀態。不假設攻擊者握有憑證。
📖 導讀
情境:內部人員,或模型檔案外流後的外部人士,知道架構與模型狀態。
假設攻擊者只掌握部分內部資訊的攻擊,同樣不假設有憑證。
📖 導讀
情境:知道對方用某個開源基礎模型,但不知道微調用了哪些資料。
留意:三種知識程度描述的是攻擊的前提條件。評估風險時,可以反問:攻擊者要知道多少才打得成?
④ AI 攻擊類型
攻擊者操縱資料,藉此影響 AI 系統的行為。
📖 導讀
情境:在公開網路爬取語料的來源網站,放入惡意內容。
留意:序言另指出,持續學習的系統在運作期收進的資料,也可能變成下一輪訓練資料。
攻擊者改動輸入,誘使 AI 系統對該輸入做出錯誤行為。附註指出,這些改動可能人眼看不出來。
📖 導讀
情境:在路標貼上人眼看不出異狀的貼紙,讓辨識系統誤判。
留意:「adversarial attack」在標準裡是同義詞,但口語常用得更寬,引用時要留意。
攻擊者想判斷「某一筆特定資料,當初有沒有被拿去訓練這個模型」。
📖 導讀
情境:判斷某位病人的病歷,是否被拿去訓練某個醫療模型。
攻擊者反覆送入自己準備的輸入、觀察輸出,藉此重建一個功能與原模型相近的模型。
📖 導讀
情境:大量查詢商用 API,用輸出訓練出自己的仿製模型。
留意:序言提到,限流之類的傳統措施能緩解,但每次查詢都合法,偵測仍是難點。
攻擊者向系統送入輸入、觀察輸出,藉此重建原始訓練資料,或其中相當大的一部分。
📖 導讀
情境:從人臉辨識系統的輸出,重建出某個人的臉。
攻擊者在開發或運作期間,直接操縱模型,以影響 AI 系統行為。
📖 導讀
情境:下載來的模型權重被換成動過手腳的版本。這個情境是作者舉例,並非定義所列。
留意:與 3.13 對照:這條直接動模型,不繞資料。
攻擊者從 AI 系統取得機密的模型參數。
📖 導讀
情境:伺服器上的模型權重檔被拷走。
攻擊者構造內容,使其作為輸入指令、或被併入輸入指令中提供給 AI 系統,觸發系統建立者不希望出現的行為。
📖 導讀
情境:網頁裡藏了一段文字,叫摘要助理把使用者的郵件轉寄出去。
標準給的是通用資安定義:一種未文件化的途徑,能繞過所有已實施的安全措施,取得對應用程式、系統或網路的未授權存取。
📖 導讀
情境:傳統資安裡,程式中留的隱藏管理帳號就屬於後門。
⑤ 洩漏類型
以下三條都是機密性(3.2)受損,差別在於「洩漏的是什麼、從哪裡漏」。
訓練資料的機密性被破壞。
📖 導讀
情境:存放訓練資料的資料庫被入侵。
留意:定義只說機密性被破壞。名稱裡的 direct,作者推讀為不經由模型;這個推讀在可見範圍內未能證實。
系統運作期間,送進模型的資料其機密性被破壞。
📖 導讀
情境:使用者送給雲端模型的提示詞,被服務端紀錄後外洩。例如對話內容被別人看到。
留意:洩漏的是運作期間的輸入,不是訓練資料。
模型輸出把先前輸入中的某部分(例如訓練資料或使用者提示詞)洩漏出來,造成機密性受損。
📖 導讀
情境:模型被問到後,把訓練資料裡的個資或別人的提示詞講出來。
留意:與 3.17 的分別:3.17 是攻擊手法,這條描述的是洩漏的結果。
⑥ AI 與環境概念
關於資料集的出處、產生時間與地點、真實性證明,或歷來與現任擁有者的紀錄。
📖 導讀
情境:訓練資料來自第三方的爬蟲資料包,無從追查出處。
與 AI 任務相關、但在訓練集中缺席或代表性不足的特徵所組成的資料,可能導致 AI 出錯。附註說明,模型遇到這類輸入時缺乏處理經驗,預測可能不準確或不可靠。
📖 導讀
情境:只用晴天照片訓練的駕駛模型,遇到大雪天。
留意:它本身不是攻擊。作者推測攻擊者可能刻意製造這類輸入,這點未查證。
可用於、或容易調整後用於一個或多個領域中各種任務的 AI 模型。附註指出,典型做法是對大量資料進行監督式或自監督式學習,且不一定涉及生成式 AI。
📖 導讀
情境:同一個通用模型被多家公司各自調整成不同用途。
留意:作者推測基礎模型的弱點可能被下游繼承,這點未查證。
以大量參數編碼自然語言運作方式的機器學習模型,可支援多種自然語言處理任務,例如文字生成、自動摘要、機器翻譯、分類。通常需要大量資料與運算資源建置。
📖 導讀
情境:文字生成、摘要、翻譯、分類,都可以由同一個 LLM 支援。
留意:它與 3.27 的關係,在可見範圍內沒有明講。作者推讀為 LLM 常是基礎模型的一種,尚未驗證。
標準以學科角度定義:研究並開發生成式 AI 系統的機制、方法與應用。附註說明它是 AI 的子學科。
📖 導讀
情境:有人說「我們導入了生成式 AI」,指的通常是一套系統;但標準定義的對象是學科。
與裝置主作業系統並行運作、但相互隔離的執行環境。
📖 導讀
情境:手機的安全區、雲端的機密運算,都屬於這類概念。
閱讀心得:看術語能讀出的三件事
1. 「直接」與「間接」是兩條路
3.18「直接模型中毒」、3.19「直接模型竊取」、3.20「直接訓練資料洩漏」都冠上 direct;對照 3.13 資料中毒、3.16 模型萃取、3.17 模型反轉、3.22 敏感輸出,則是繞一圈,透過資料或查詢達成目的。作者的推論是:保護模型檔案本身,和保護查詢介面,是兩套不同的控制。
2. 標準把「失效」和「攻擊」分開
3.7 failure 是一般品質概念,3.5 attack 才是帶惡意的行為。AI 出錯不一定是被攻擊,像 3.26 的分布外資料就是自然發生。分析事故時要先分辨,不能把每個錯誤都當成攻擊。
3. 有些定義是借用傳統資安的
3.1 至 3.9、3.25、3.26、3.30 都標明引自既有標準(27000、27002、27033-1、22300、5259-1、PAS 8800、27071 等)。這呼應序言的立場:AI 威脅是在傳統資安之上加一層,而不是另起爐灶。
範圍與聲明
- 資料來源:ISO 官方 Online Browsing Platform(OBP)上公開的 Foreword、Introduction、第 1 至 3 章與 Bibliography。2026-10-17 讀取。
- 不含:第 4 章起的條文、威脅與緩解細節、附錄。這些為付費內容,OBP 預覽未開放,本頁不涉及。
- 意譯,非逐字轉載:各條說明為作者以繁體中文重寫的白話版本,並非 ISO 官方翻譯,也非原文;用語若有出入,以官方英文版為準。需要精確用字時,請至 OBP 或購買正式版本查閱。
- 「大致相當於」、「用途」與每條「導讀」:為作者個人的解讀與整理(情境多為作者舉例),不屬於標準內容;標示「未驗證」處,是預覽範圍內無法確認的推測。
- 圖:「攻擊落點圖」由 Codex image_gen 生成,條號與用語已逐項人工核對;圖為作者整理,非 ISO 官方圖。
- 連結:ISO OBP 官方預覽頁|回到完整研析報告